Google เปิดตัว Gemini 3.5 Transcribe ถอดเสียงแม่นยำ รองรับกว่า 85 ภาษา
Google เปิดตัว Gemini 3.5 Transcribe โมเดลถอดเสียงอัจฉริยะ รองรับกว่า 85 ภาษา แยกผู้พูดได้ พร้อมประมวลผลแบบเรียลไทม์
Google เปิดตัว Gemini 3.5 Transcribe โมเดลแปลงเสียงเป็นข้อความ (Speech-to-Text) รุ่นใหม่ที่แม่นยำที่สุดของบริษัท ออกแบบมาสำหรับการโต้ตอบด้วยเสียงอย่างชาญฉลาด สามารถจัดการเสียงรบกวน คำศัพท์เฉพาะ และคำพูดที่ไม่ต่อเนื่อง พร้อมแปลงเสียงดิบให้เป็นข้อความที่อ่านง่ายและจัดรูปแบบให้อัตโนมัติ
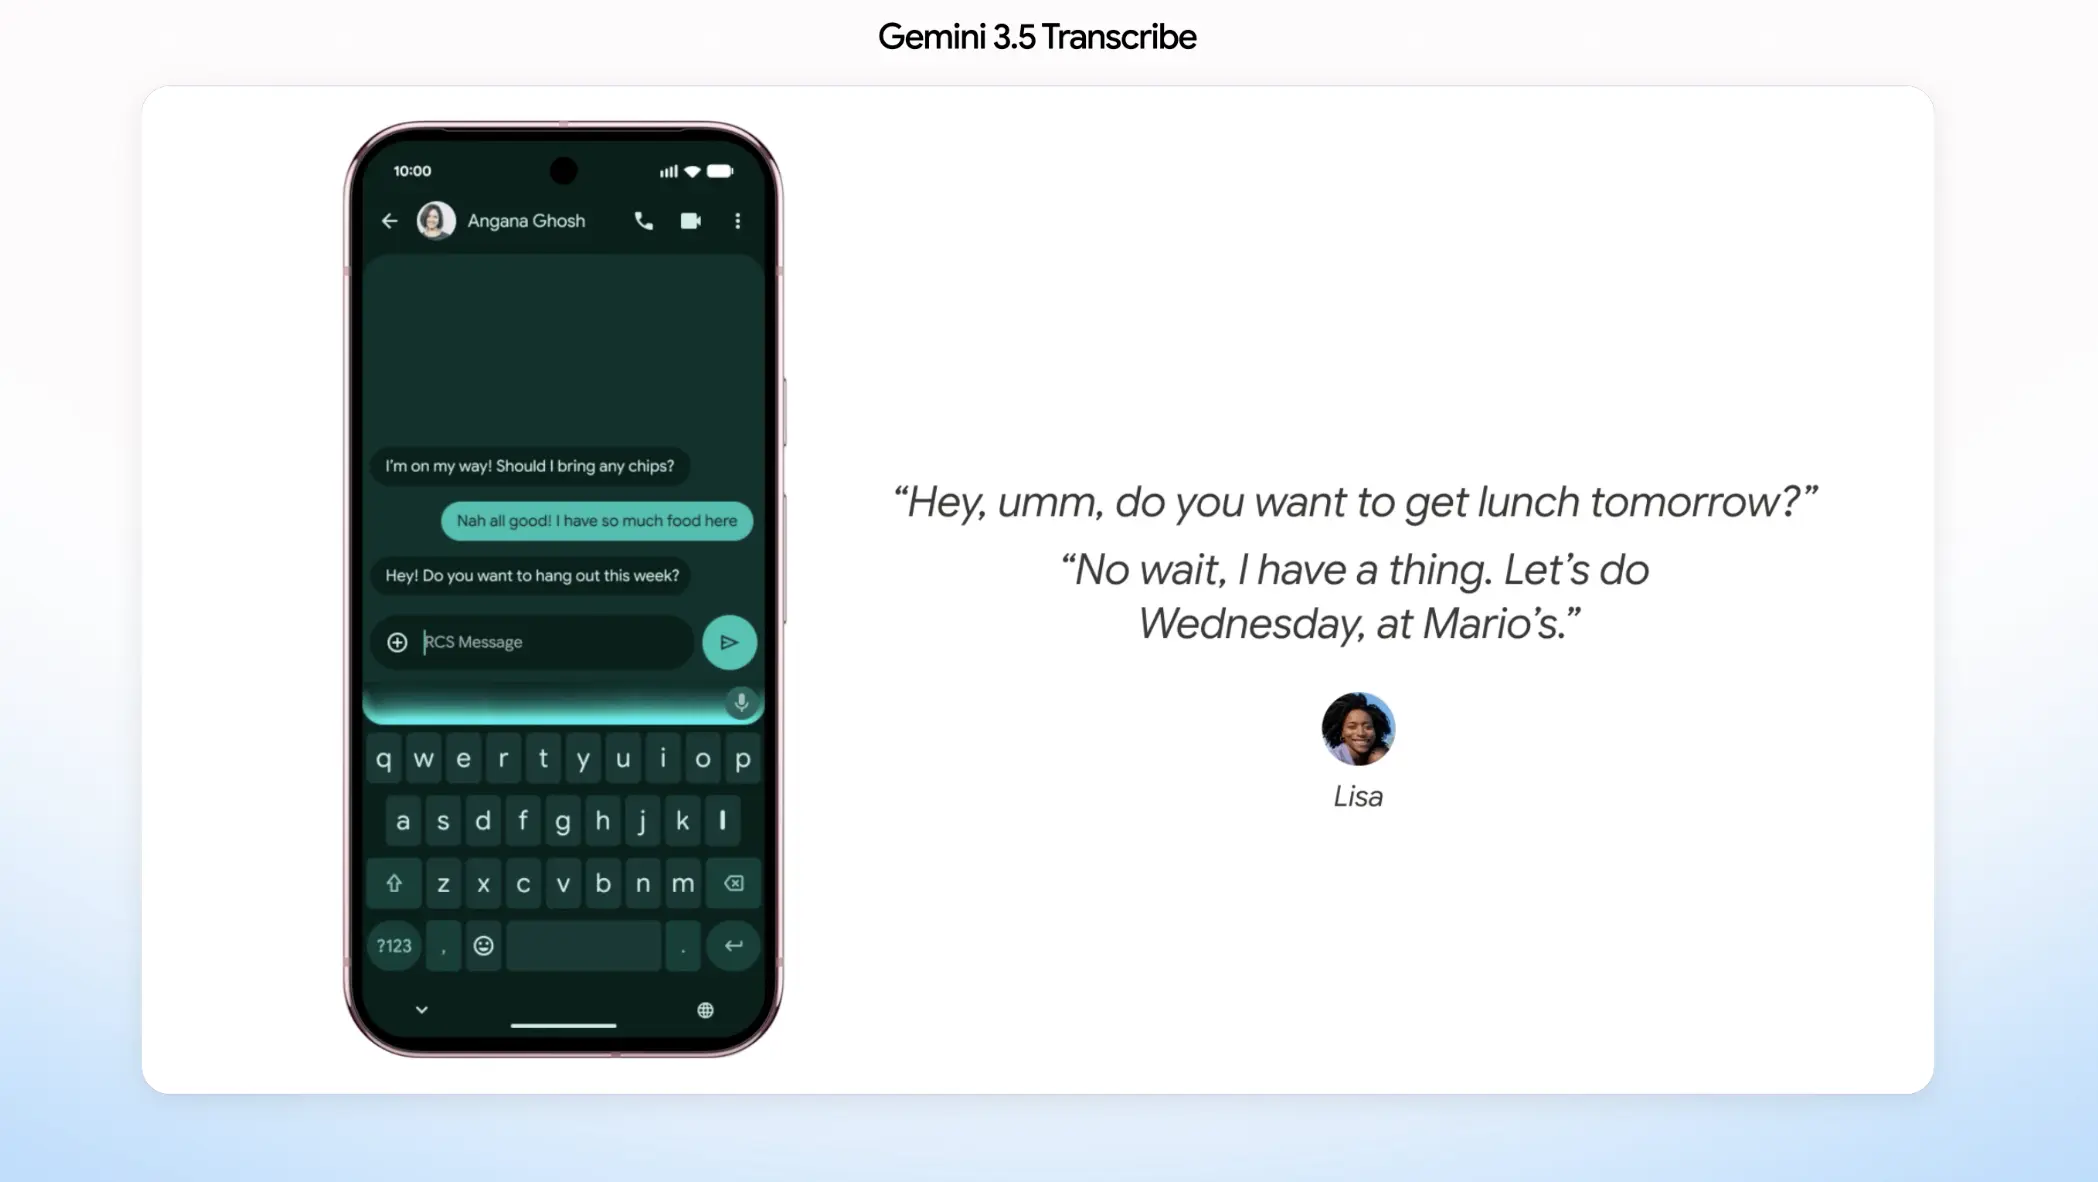
เทคโนโลยีดังกล่าวถูกนำไปใช้กับผลิตภัณฑ์ของ Google แล้ว เช่น ฟีเจอร์ Rambler บน Android และแอป Gemini บน macOS ส่วนฝั่งนักพัฒนาสามารถเข้าถึงโมเดลผ่าน Gemini API ใน Google AI Studio และ Gemini Enterprise Agent Platform
รองรับทั้งการถอดเสียงแบบเรียลไทม์และไฟล์บันทึกเสียง
Gemini 3.5 Transcribe ให้บริการผ่าน API สองรูปแบบ ได้แก่
- Real-time streaming: ส่งข้อมูลเสียงและรับข้อความถอดเสียงอย่างต่อเนื่องแบบสองทิศทาง มีความหน่วงต่ำกว่าหนึ่งวินาที เหมาะกับแอปสั่งงานด้วยเสียงและระบบโต้ตอบแบบเรียลไทม์ ผ่าน Live API โดยใช้โมเดล
gemini-3.5-transcribe-live - Pre-recorded audio processing: รองรับการถอดเสียงจากไฟล์บันทึก การประชุม และบันทึกการสนทนาทางโทรศัพท์ พร้อมระบุผู้พูดและแสดงเวลาในระดับคำ ผ่าน Interactions API โดยใช้โมเดล
gemini-3.5-transcribe
โมเดลถูกออกแบบให้ผสานเข้ากับขั้นตอนการพัฒนาซอฟต์แวร์ได้ง่าย ไม่ว่าจะเป็น Voice Agent เครื่องมือสร้างคำบรรยายแบบเรียลไทม์ หรือระบบวิเคราะห์ข้อมูลหลังจบการสนทนา
เข้าใจการพูดที่เป็นธรรมชาติและจัดข้อความให้อัตโนมัติ
Gemini 3.5 Transcribe สามารถเข้าใจรูปแบบการพูดและเจตนาของผู้ใช้ได้ดีขึ้น พร้อมรองรับความสามารถสำคัญ ดังนี้
- Smart Transcription: เข้าใจการแก้คำพูดกลางประโยค เช่น “นัดวันอังคาร—ไม่ใช่ วันพุธ” พร้อมตัดคำฟุ่มเฟือยอย่าง “เอ่อ” หรือ “อืม” และจัดรูปแบบข้อความให้อัตโนมัติ
- Function Calling: ส่งต่องานที่ซับซ้อน เช่น การสร้างภาพหรือวิเคราะห์ไฟล์ให้ Gemini โมเดลอื่นทำงานต่อได้ ปัจจุบันรองรับในแอป Gemini บน macOS
- Custom Vocabulary: ปรับการถอดเสียงตามรายการคำศัพท์ที่ผู้ใช้กำหนด ช่วยให้จดจำศัพท์เฉพาะและการสะกดชื่อที่ไม่เหมือนคำทั่วไปได้ดีขึ้น
- Global Language Support: ตรวจจับและถอดเสียงได้อัตโนมัติมากกว่า 85 ภาษา พร้อมรองรับสำเนียงและภาษาถิ่นที่หลากหลาย
- Multi-speaker Identification: แยกและระบุผู้พูดในไฟล์เสียงที่บันทึกไว้ได้สูงสุด 3 คน พร้อม Time Stamp ส่วนการรองรับผู้พูดมากกว่า 3 คนยังอยู่ในขั้นทดลอง
ผลทดสอบโดย Artificial Analysis ระบุว่า Gemini 3.5 Transcribe มีอัตราความผิดพลาดของคำ (Word Error Rate หรือ WER) เฉลี่ย 4.0% สำหรับการถอดเสียงแบบ Streaming และ 2.6% สำหรับแบบ Non-streaming
โมเดลยังทำงานได้ดีในสภาพแวดล้อมจริงที่มีเสียงรบกวน และสามารถจับข้อมูลที่ประกอบด้วยตัวอักษรและตัวเลข เช่น รหัสไปรษณีย์หรือหมายเลขคำสั่งซื้อได้อย่างแม่นยำ
เร็วกว่า Chirp 3 และถอดเสียงหลายภาษาได้ดีขึ้น
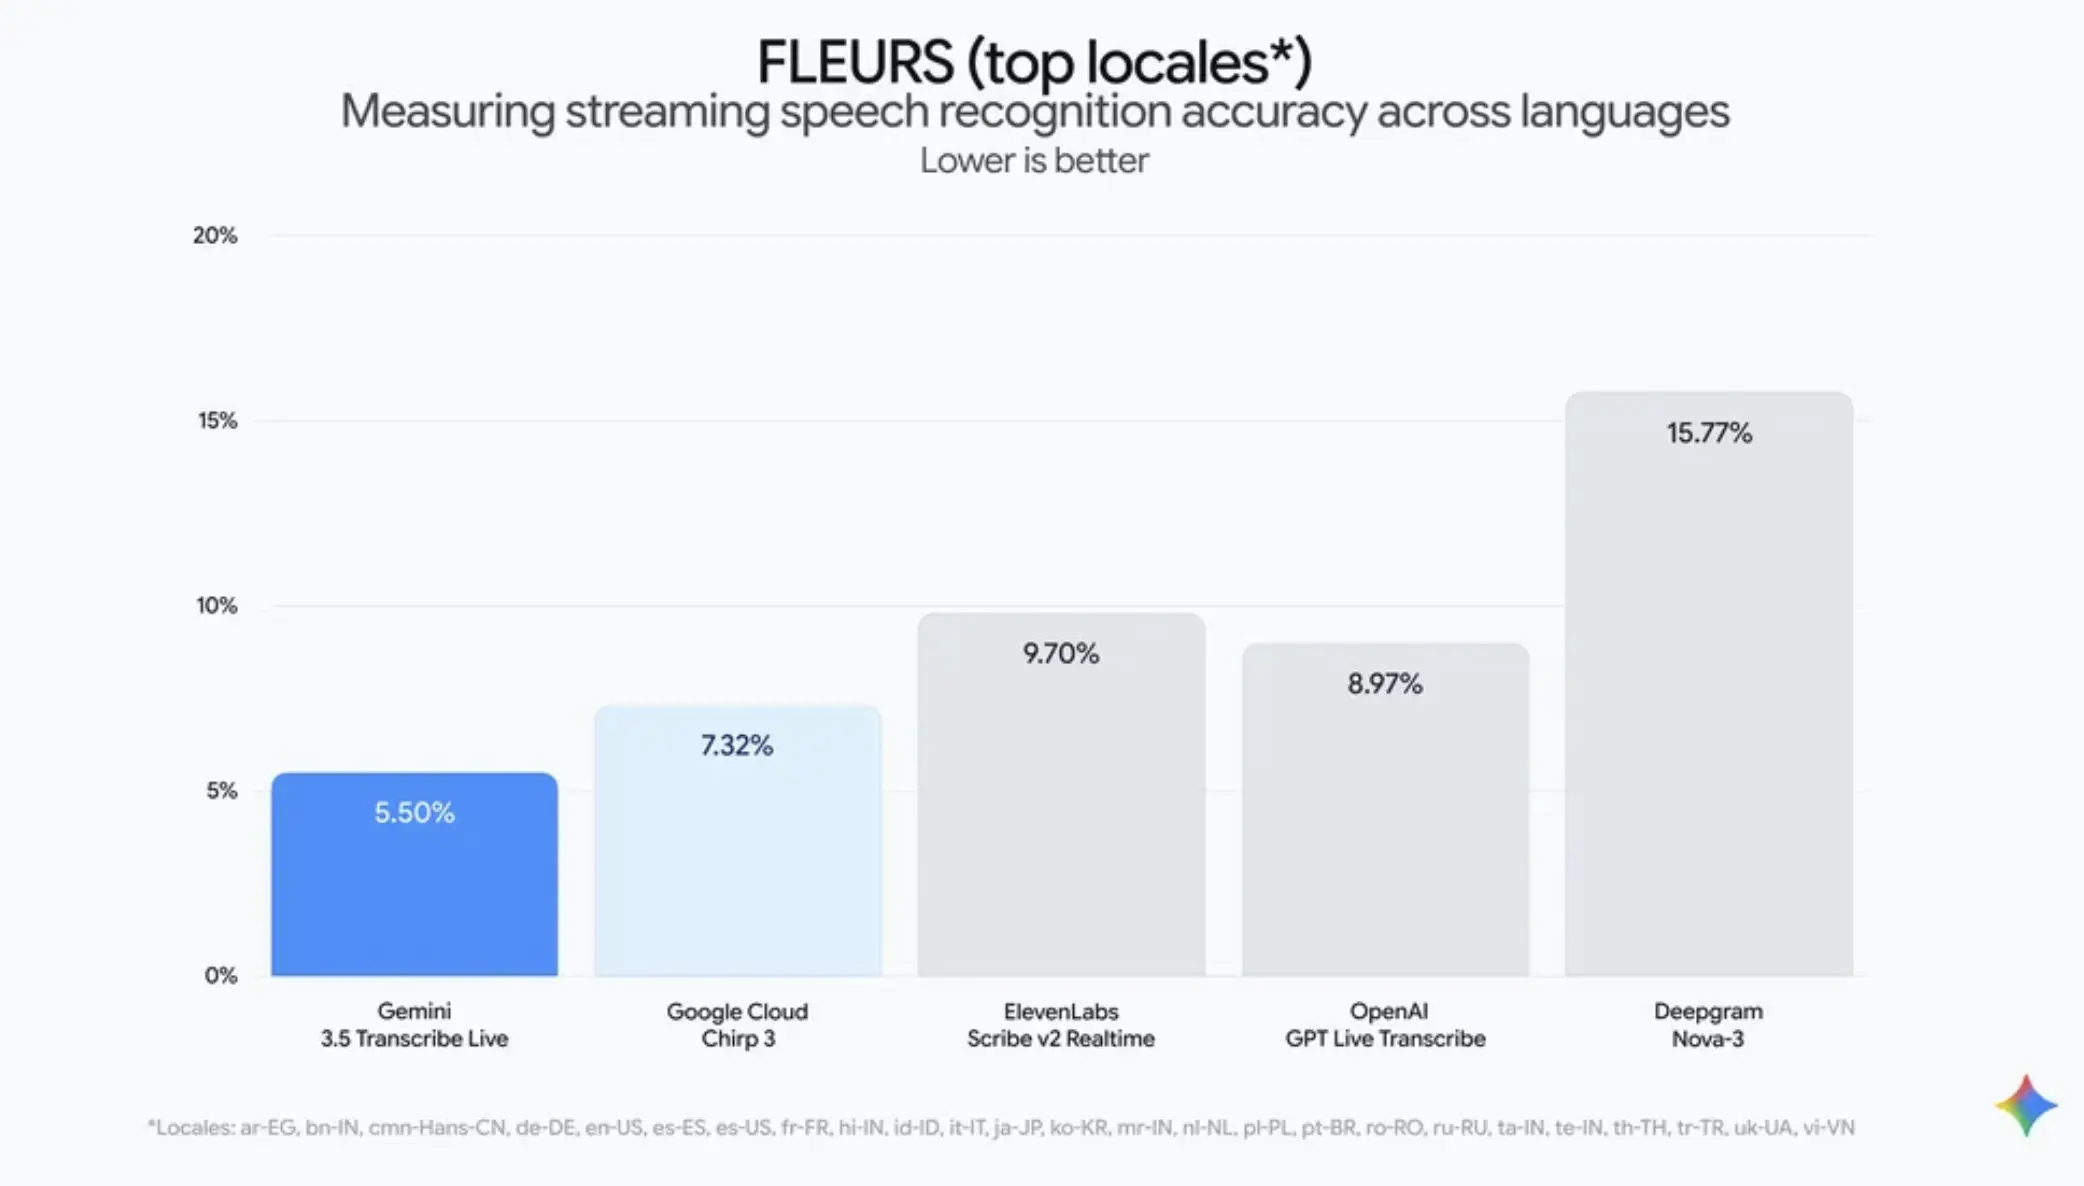
Google ระบุว่า Gemini 3.5 Transcribe พัฒนาขึ้นจากโมเดลถอดเสียงรุ่นก่อนอย่าง Chirp 3 ทั้งด้านความสามารถ อัตราความผิดพลาด และความหน่วงในการประมวลผล
จากการวัดของ Artificial Analysis ระยะเวลาที่ใช้จนได้ข้อความถอดเสียงฉบับสมบูรณ์ลดลง 70% ส่วนการทดสอบ FLEURS ในกลุ่มภาษาและภูมิภาคหลัก พบว่าโมเดลมีค่า WER อยู่ที่ 5.50% ในโหมด Streaming และ 5.04% ในการประมวลผลแบบ Non-streaming
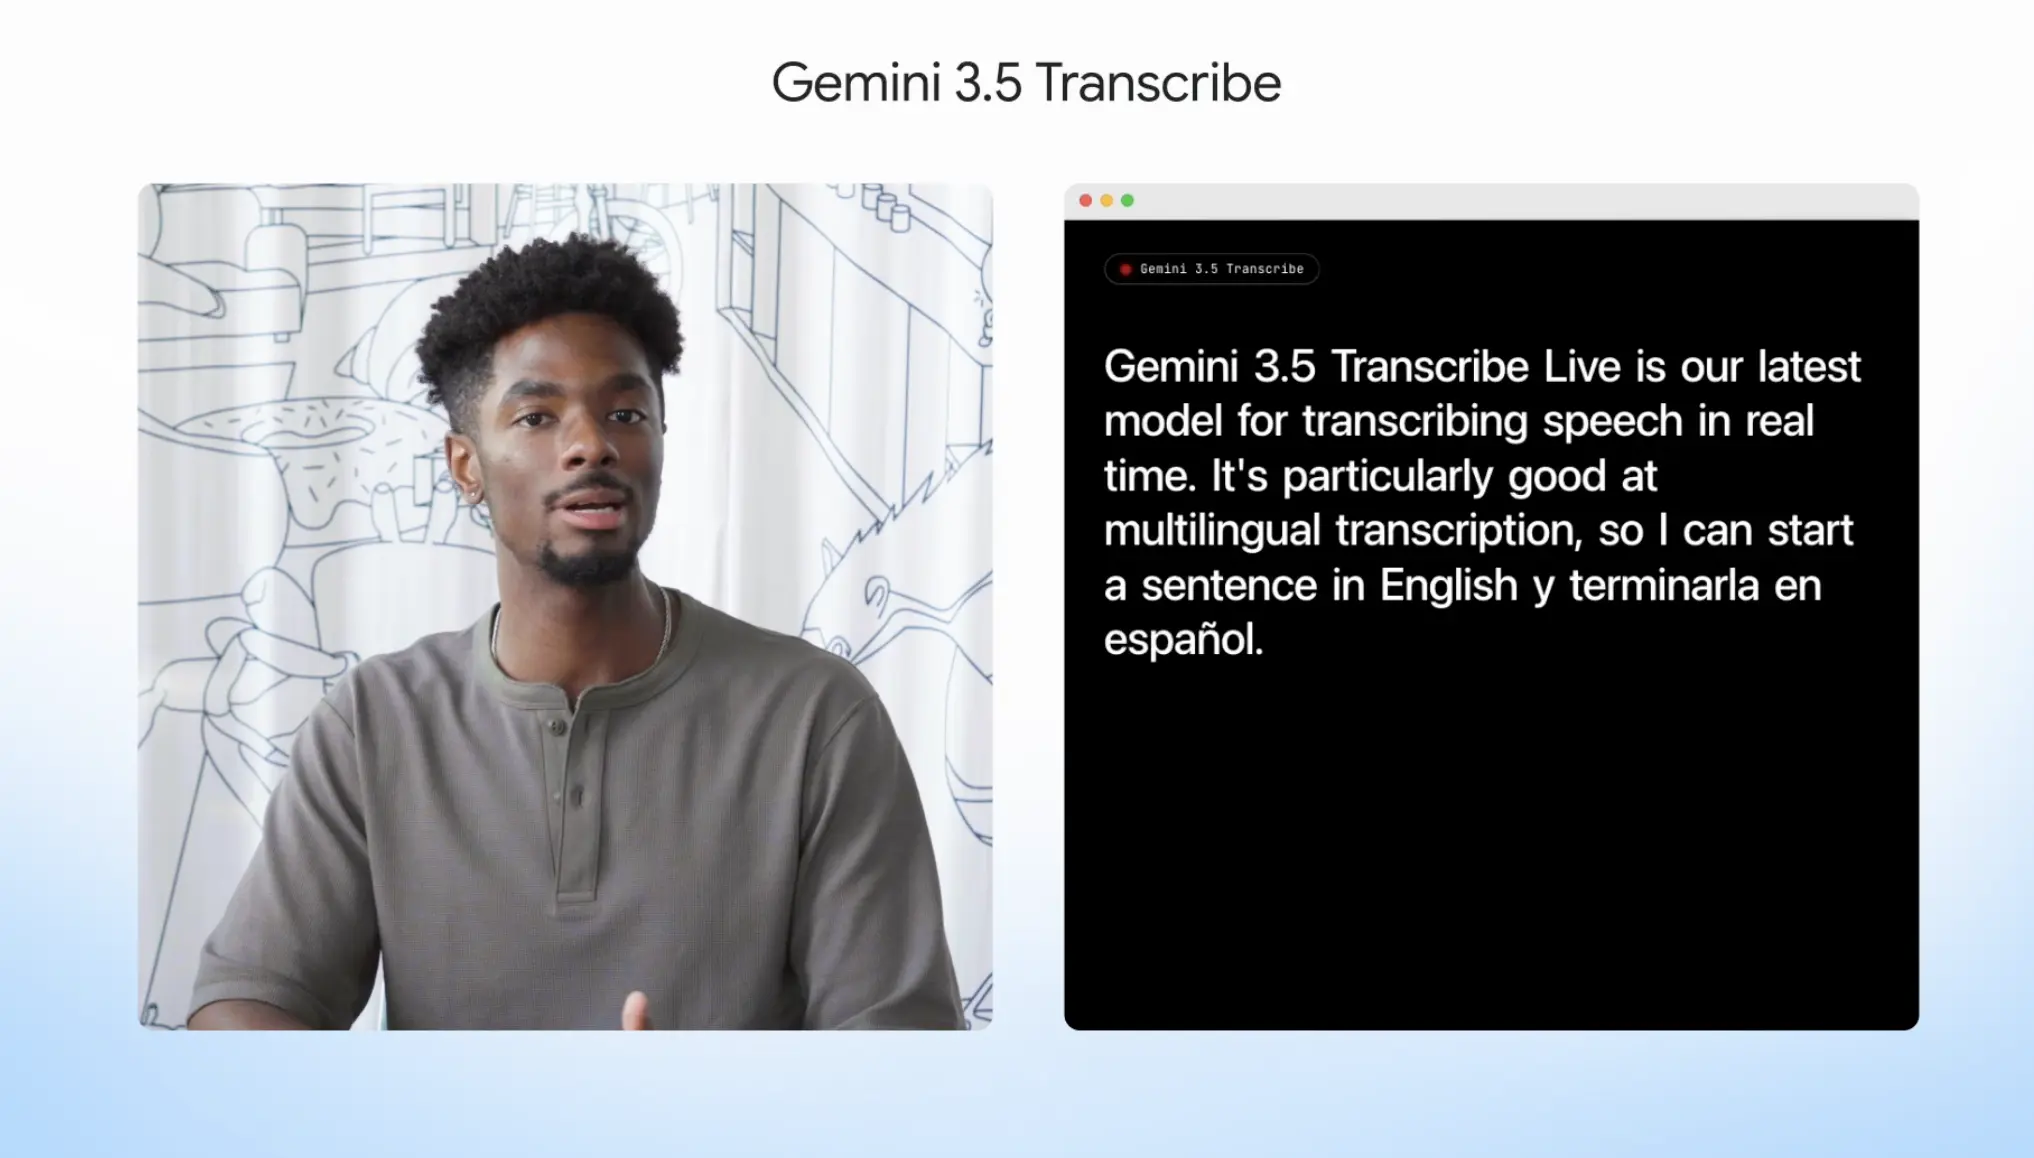
ใช้งานร่วมกับ Gboard, Antigravity, Gemini และ Chrome
Google นำความสามารถด้านการเข้าใจบริบทของ Gemini 3.5 Transcribe ไปใช้กับบริการหลายประเภท เพื่อให้การสั่งงานและพิมพ์ข้อความด้วยเสียงเป็นธรรมชาติมากขึ้น
- Gboard บน Android: ฟีเจอร์ Rambler สามารถเปลี่ยนคำพูดให้เป็นข้อความที่จัดรูปแบบแล้ว ตัดคำฟุ่มเฟือย รวมถึงใช้เสียงเพื่อแก้ไขคำผิดและเปลี่ยนสไตล์การเขียนได้
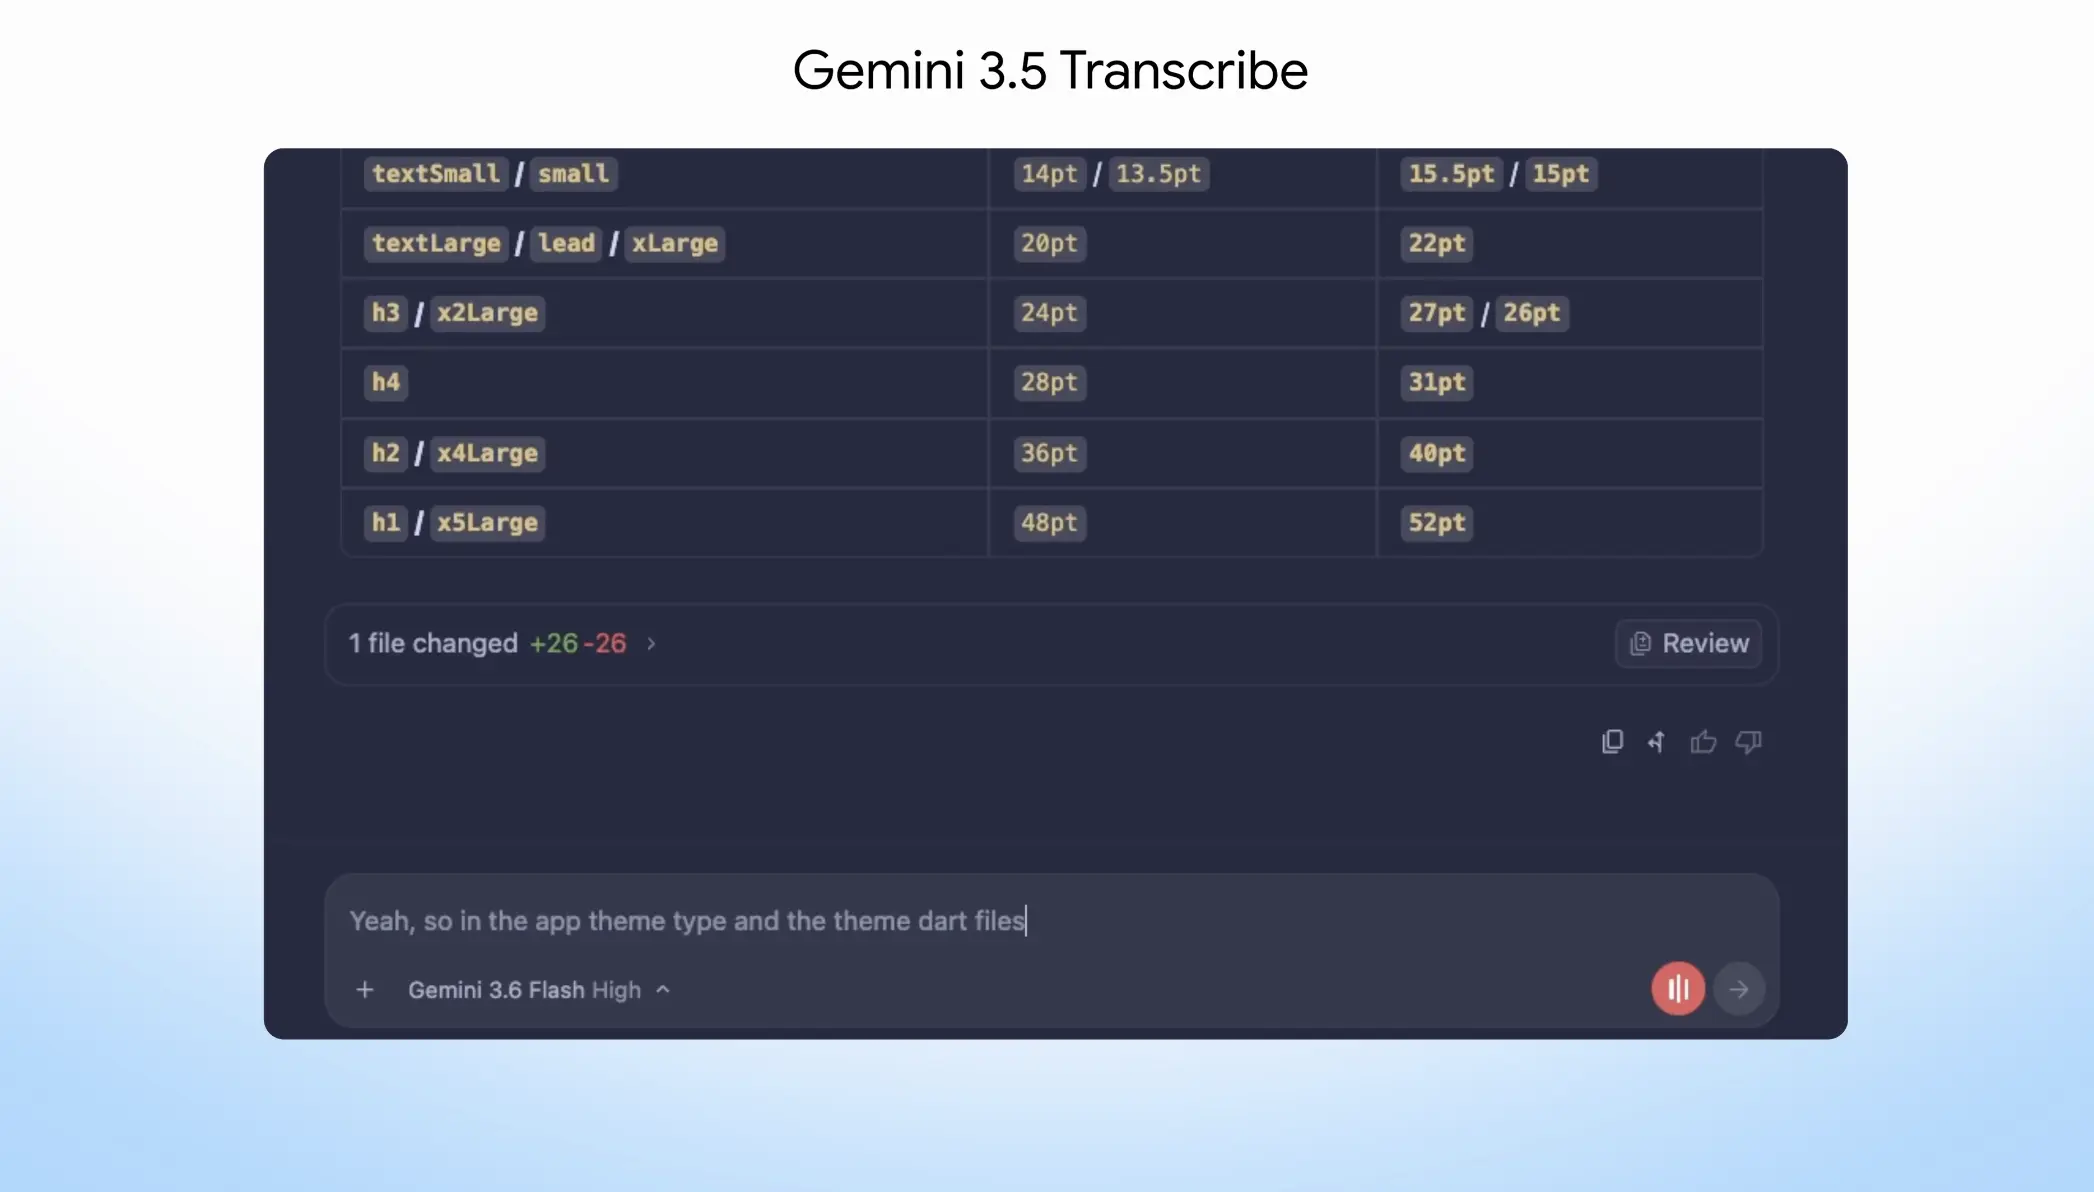
- Google Antigravity: ใช้บริบทบนหน้าจอและประวัติการสนทนาเมื่อได้รับอนุญาต เพื่อถอดชื่อไฟล์ ความคิดของ Agent และเนื้อหาในเอกสารที่กำลังเปิดอยู่ได้แม่นยำขึ้น
- Google AI Studio: รองรับ Gemini 3.5 Transcribe ใน Build Mode ช่วยให้นักพัฒนาสร้างแอปด้วยการสั่งงานด้วยเสียง
- Gemini บน macOS: เปลี่ยนคำพูดแบบธรรมชาติเป็นข้อความที่จัดรูปแบบแล้ว พร้อมใช้คำสั่งเสียงร่วมกับบริบทบนหน้าจอ เพื่อสรุปไฟล์ในเครื่อง นำข้อความไปปรับใช้ข้ามแอป หรือสร้างภาพบริเวณตำแหน่งเคอร์เซอร์
- Chrome: เตรียมเพิ่มฟีเจอร์พูดเพื่อพิมพ์ในช่องข้อความบนเว็บไซต์ ช่วยให้ผู้ใช้ตอบข้อความ ร่างโพสต์ หรือเขียน Prompt สำหรับ Gemini ด้วยเสียงได้
เปิดให้ทดลองใช้งานแล้ว
นักพัฒนาสามารถทดลอง Gemini 3.5 Transcribe แบบ Public Preview ผ่าน Gemini API ใน Google AI Studio และ Google Antigravity ส่วนลูกค้าองค์กรสามารถใช้งานผ่าน Gemini Enterprise Agent Platform และจะรองรับ Gemini Enterprise for Customer Experience ในภายหลัง
สำหรับผู้ใช้ทั่วไป โมเดลเปิดให้ใช้งานแล้วผ่านแอป Gemini บน macOS ในภาษาอังกฤษ และฟีเจอร์ Rambler บน Android ในบางประเทศและบางภาษา ส่วนการรองรับบน Chrome จะเปิดให้ใช้งานเร็ว ๆ นี้
แพลตฟอร์มสำหรับนักพัฒนา ได้แก่ Agora, Fishjam, LangChain, LiveKit, Pipecat, Vercel และ Vision Agents ได้นำ Gemini Live API ไปใช้สำหรับสร้างระบบโต้ตอบด้วยเสียง ขณะที่ vivo, Intellitek Health และ Lingopal ให้ความเห็นเชิงบวกเกี่ยวกับความหน่วงต่ำ ความแม่นยำ และการรองรับภาษาที่หลากหลายของโมเดล
ที่มา: Google